DEEPSEEK-R1 纯强化学习推理大模型全面就绪

探索认知未至之境
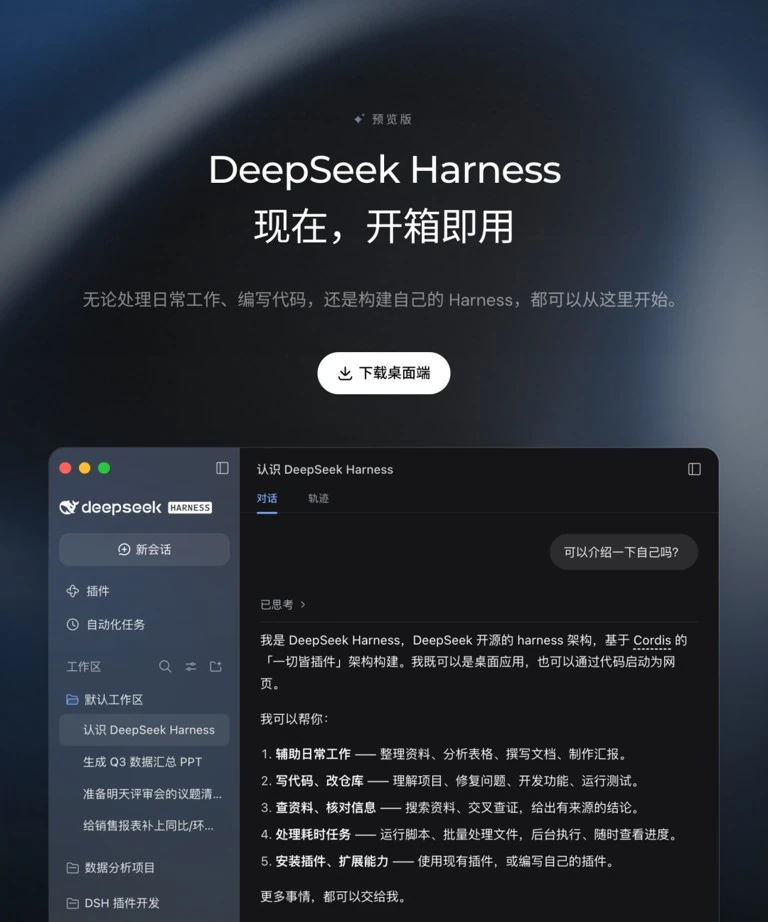
DeepSeek 官方入口

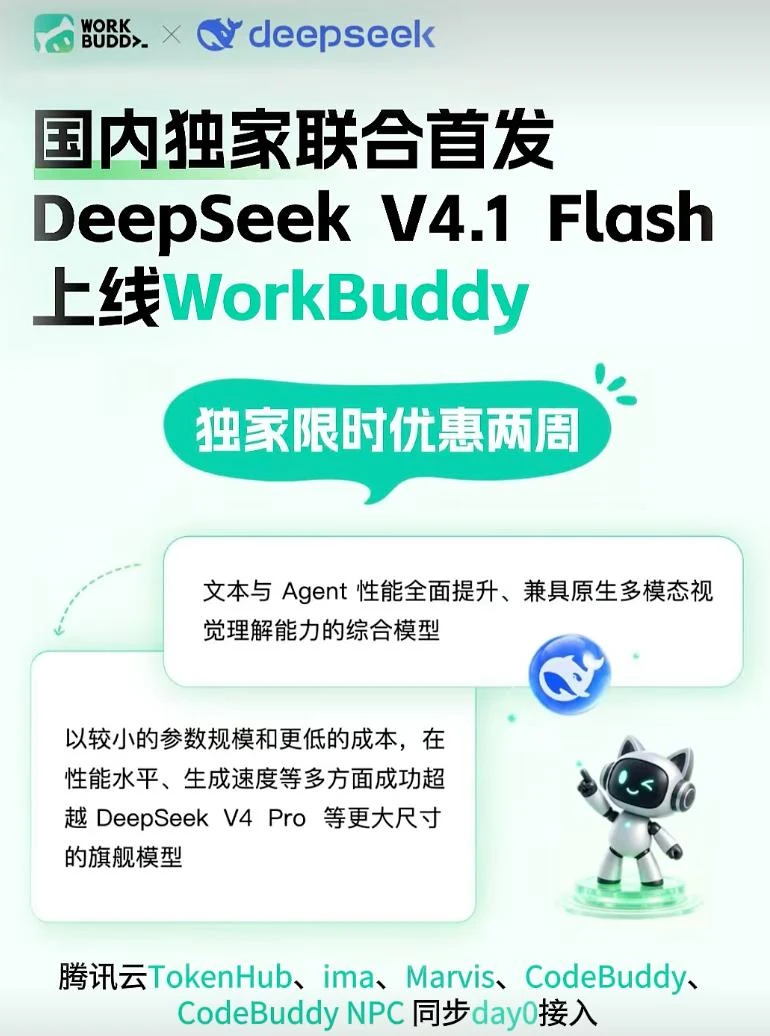
DeepSeek 始终坚持底层算法原创,突破模型纯强化学习自省推理难题。免去繁琐复杂的本地依赖配置,直达 DeepSeek 网页版入口体验 R1 满血版显式思维链推演,接入工业级低成本高吞吐 API 开放平台与 Harness 严苛评测矩阵。
DEEPSEEK_REASONING_CONSOLE.SH
DeepSeek 在线体验推演演示界面
[ 显式思维链已闭环 · 收敛度 100% ] 进入工作台
CORE ARCHITECTURE

底层硬核基座推演能力

完全基于数学算法创新压缩推理算力开销,重构复杂逻辑深度推演基准。

SPEC // 01

多头潜在注意力 (MLA)

基于低秩压缩投影架构,大幅压减超长上下文推理的 KV Cache 内存占用,并发吞吐提升数倍。

KV 显存极致压缩
SPEC // 02

纯强化学习逻辑自省

摆脱对大量人工冷启动标注的依赖,模型在大规模数学证明与复杂算法代码中自发演进反思与回溯机制。

显式思维链 (CoT)
SPEC // 03

256 专家细粒度 MoE

总参数量达 671B,推理激活仅约 37B,无辅助损失负载均衡机制兼顾大模型容量与极致能效比。

稀疏专家动态路由
SPEC // 04

原生 128K 超长上下文

单次请求支持数十万字工程文档与代码树通读,配合创新的硬盘上下文感知缓存,调用费率低至每百万 0.14 元。

存储缓存感知
INDUSTRIAL DOMAINS

极低容错的工业级研发应用场景

不仅服务于日常交互,更能深入严谨学术研究、量化金融与复杂系统工程。

跨工程依赖代码重构

穿透微服务依赖拓扑图,排查并发竞态死锁与内存越界隐患,生成带严格逻辑归纳证明的修补补丁。

奥林匹克数理符号证明

在 AIME、MATH 等高难度竞赛题目中展开长程多分支逻辑推演,自动寻找反例并完成闭环验证。

跨境并购协议合规审查

基于 128K 超长上下文窗口,针对数百页上市公司审计报告与投资协议进行穿透式条款核验与风险评级。

量化多因子因果回测

从混沌高频市场行情中挖掘稳健非线性因子,推演在极端流动性冲击条件下的投资组合抗风险韧性。

自主循环智能体 (Agent)

深度支持工具调用 (Tool Call) 与环境反馈,支持在沙箱环境中自主编写并运行测试用例纠错。

企业内网完全离线部署

利用 1.5B 到 70B 官方蒸馏权重,在企业私有服务器集群中无网络离线运行,核心研发资产严密封锁。

PORTFOLIO MATRIX

产品矩阵与规格选型

按照实际业务负载的逻辑复杂度、时延敏感度与显存预算自由选择。

DeepSeek-V3
PRODUCTION WORKHORSE // 通用高性能
技术特性:671B 超大规模参数 + 256 专家细粒度稀疏路由
适用场景:高并发生产环境对话、海量数据清洗、中英文案生成与全格式翻译
¥ 0.14
每百万 Tokens (缓存命中)
查看 API 文档
DeepSeek Distill
EDGE & LOCAL // 私有化蒸馏矩阵
技术特性:基于 R1 推理思维链微调蒸馏,1.5B ~ 70B 灵活参数
适用场景:离线保密工作站、嵌入式边缘终端、个人开发机本地 Ollama 部署
开源免费
MIT / Apache 商业友好许可
本地部署教程
DeepSeek API开放平台接入拓扑
API ARCHITECTURE

三行代码,极速接入生产环境

DeepSeek API 开放平台全面拥抱行业通用标准协议,原有技术栈无须进行破坏性重构,仅需变更 Base URL 与 API Key 即可享受数十倍成本缩减。

  • 01
    全兼容标准协议:直接复用现有的主流客户端与 SDK,支持端到端 SSE 流式响应。
  • 02
    智能上下文缓存感知:系统自动复用相似长 Prompt 的 KV 缓存,响应延迟缩减最高 80%。
  • 03
    工业级 SLA 保障:全球高可用节点就绪,内置双活弹性调度与自动重试机制。
DeepSeek 获取入口与多端使用场景
EMPIRICAL BENCHMARKS

以扎实的数据证明技术突破

不靠营销声量,完全以形式化测试基准与工程成本为指标衡量模型优越性。

99.8%
AIME 逻辑推演收敛准确率
在国际高等数学奥赛基准集上展现极强的严谨推导闭环能力
¥ 0.14
每百万 Tokens 缓存命中极低价
以革命性的算法优化击穿推理成本底线,全面赋能开发者生态
128K
原生上下文窗口深度
轻松吞吐数十万字整套工程代码库或学术论著,记忆无损提取
60+ QPS
企业默认弹性并发保障
毫秒级首字延时响应,支撑日均亿级 Token 复杂推演生产请求

立即步入 DeepSeek 逻辑自省与智能推演空间

无需繁琐的认证流程,直接通过网页版入口体验 R1 满血版深度思考。

进入网页版入口
EVALUATION SUITE

DeepSeek Harness 自动化评测规范

专为强化学习自省推理模型打造的开源测试工作流,通过动态沙箱执行代码、形式化符号化验证,消除静态选择题评测中普遍存在的“记忆刷榜”现象。

bash_harness_benchmark.sh Harness v2.4
# 1. 克隆官方 Harness 评测套件
git clone https://github.com/deepseek-ai/deepseek-harness.git
cd deepseek-harness

# 2. 安装环境并执行全自动化逻辑闭环测试
pip install -r requirements.txt
python -m harness.evaluate \
  --model deepseek-reasoner \
  --tasks aime2024,math500,swe-bench \
  --temperature 0.0 \
  --output_dir ./reports
全自动化代码沙箱隔离
在独立轻量容器中即时编译、运行生成的解决方案,针对极端 Corner Case 进行压力回归检验。
思维链长程自省收敛打分
分析推理过程中出现回溯、假设推翻与反思重构的步长,精准量化大模型的深度逻辑推理真实度。
COMMON INQUIRIES

常见问题与深度解答

为您梳理 DeepSeek 网页版入口、API 价格标准与开源部署的核心疑问。

答:DeepSeek 官网网页版目前对所有用户提供免费在线体验通道,涵盖 DeepSeek-V3 与 DeepSeek-R1(深度思考版)等主流基座。用户登录后即可免配置开启 128K 超长上下文推演与文件通读解析。
答:传统大模型通常仅进行单向词元预测,难以应对多步强逻辑验证。DeepSeek-R1 引入纯强化学习自省机制,在给出结论前会完整展示其内在的思维演进过程(包括假设检验、自我推翻反思、边界重构等),推演透明度与数学严谨度显著跃升。
答:平台采用创新的上下文缓存感知(Cache-Aware)计费机制。对于命中本地缓存的输入 Token,单价仅为每百万 Tokens ¥0.14 元;未命中输入为每百万 Tokens ¥2.00 元(R1 为 ¥4.00 元)。此机制针对多轮连续会话或长系统提示词场景,可降低高达 70%~90% 的调用成本。
答:DeepSeek 已开源基于主流架构的 1.5B 到 70B 蒸馏版模型,完全支持通过 Ollama、vLLM 或 llama.cpp 进行本地部署。个人开发工作站使用 16GB 显存显卡即可流畅运行 7B/14B 量化版本,企业内网单台双卡 RTX 4090 或 A100 即可运行 32B/70B 生产级推理。
LATEST ANNOUNCEMENTS

技术通告与生态进展

实时追踪 DeepSeek 底层算法突破、评测套件更新与开发者赋能计划。

2026.10 // 架构升级

DeepSeek-R1 纯强化学习数学自省推演机制全球上线

首次实现无监督人工冷启动下的超长逻辑链自发演进,AIME 成绩大幅提升。

体验推演 →
2026.09 // 开发者生态

DeepSeek Harness 自动化模型评测框架全面开源

包含多轮逻辑对抗、形式化代码验证与长上下文检索基准,助推开源生态发展。

查看规范 →
2026.08 // 算力普惠

API 开放平台上下文缓存优化上线,输入成本击穿至 0.14 元

利用低秩注意力与硬件存储协同调度,助力数万家创新企业完成智能化升级。

价格明细 →
2026.07 // 生态合作

主流开源推理引擎 Ollama 与 vLLM 全面原生支持 DeepSeek 蒸馏矩阵

支持 1.5B ~ 70B 全系列蒸馏权重的一键式拉取与内网无缝部署。

部署指南 →
2026.06 // 移动升级

DeepSeek 网页版入口移动端界面重构完成

轻量化交互架构,针对手机屏幕优化思维链折叠展示与语音交互体验。

立即访问 →